El SEO técnico es el conjunto de trabajos que se hacen sobre la infraestructura de una web para que Google pueda rastrearla, entenderla e indexarla sin obstáculos. No se ocupa del contenido ni de las palabras clave, sino de que los cimientos funcionen: velocidad, códigos de respuesta, sitemap, robots.txt, canonicals, versión móvil y datos estructurados.
Es el área que menos se ve desde fuera y la que más bloquea cuando está rota. Una web puede tener el mejor contenido de su sector y no aparecer en ningún resultado porque un archivo de doce líneas le está diciendo a Google que no pase.
Lo que viene son las ocho áreas que cubre, una tabla para diagnosticar qué te está pasando a ti antes de tocar nada, ejemplos de fallos reales y lo que ya dejó de ser SEO técnico aunque siga apareciendo en guías. Si buscas el mapa completo, está en dónde encaja lo técnico entre las demás áreas del SEO.
SEO técnico y técnicas SEO no son lo mismo
Conviene despejarlo antes de seguir, porque Google mezcla las dos búsquedas en los mismos resultados y eso confunde a mucha gente.
El SEO técnico es un área de trabajo: la infraestructura del sitio. Las técnicas SEO son métodos concretos que se aplican en cualquier área, incluido el contenido y los enlaces. Alguien que busca «técnicas SEO» quiere un listado de acciones para mejorar su posicionamiento; alguien que busca «SEO técnico» quiere entender por qué su web no indexa.
La confusión tiene un motivo gramatical: en español «técnico» como adjetivo y «técnica» como sustantivo se parecen demasiado. En inglés no pasa, porque son technical SEO y SEO techniques. Si has llegado buscando lo segundo, este artículo no es el que necesitas.
Por qué el SEO técnico va primero
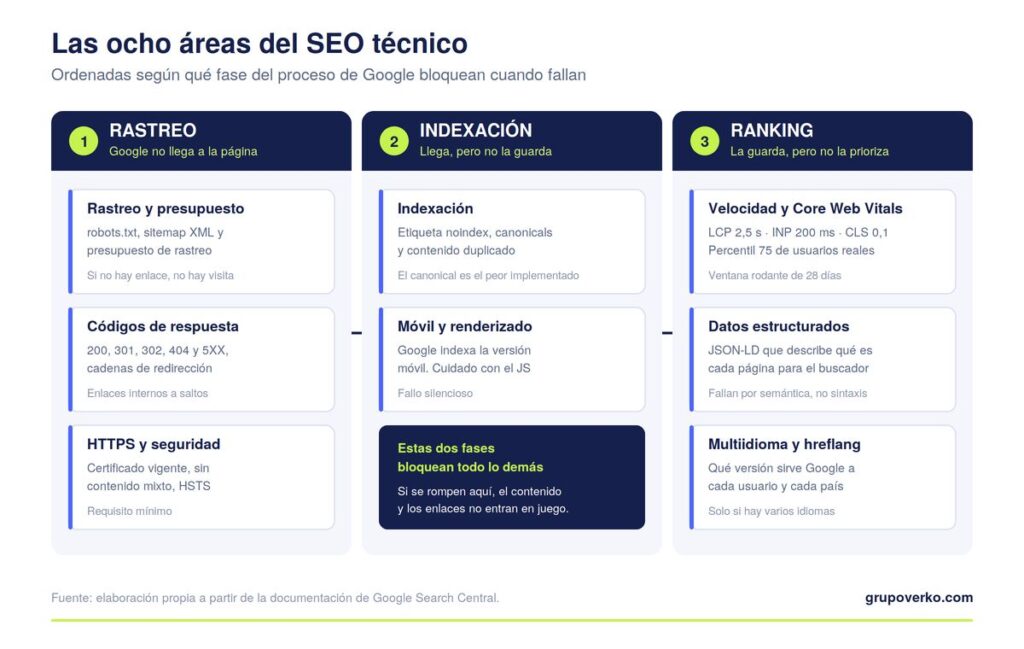
Porque las tres fases del funcionamiento de un buscador ocurren en orden y cada una depende de la anterior. Google rastrea, después indexa y solo entonces posiciona. Un fallo técnico corta la cadena en la primera o la segunda fase, y en ese punto el contenido y los enlaces todavía no han entrado en juego.
La consecuencia práctica se ve en cualquier auditoría: invertir en artículos o en enlaces mientras la mitad de las páginas no se indexan es gastar presupuesto en algo que Google no está mirando. Y como casi el 94 % de la búsqueda en España pasa por Google, un bloqueo técnico que le afecte a él deja fuera prácticamente todo el canal.
Qué incluye el SEO técnico
Ocho áreas, ordenadas por lo que rompen cuando fallan.
Rastreo: robots.txt, sitemap y presupuesto de rastreo
El robots.txt indica qué partes del sitio pueden recorrer los rastreadores. Una regla mal escrita puede bloquear una sección entera sin que nadie se entere durante meses. El sitemap es la lista de URLs que quieres que Google conozca, y tiene que contener solo páginas indexables que devuelvan 200.
El presupuesto de rastreo es el número de URLs que Googlebot recorre en tu sitio en un periodo. Importa en webs grandes y en las que desperdician rastreo en archivos pesados, páginas duplicadas o parámetros de filtros que generan miles de URLs sin valor.
Indexación: noindex, canonicals y contenido duplicado
Una página rastreada puede no indexarse por varios motivos: llevar una etiqueta noindex, tener un canonical que apunta a otra URL, ser casi idéntica a otra, o sencillamente no aportar suficiente para que Google decida guardarla.
El canonical señala cuál es la versión principal cuando existen varias parecidas. Es la etiqueta que más se implementa mal: canonicals apuntando a la home desde todas las páginas, canonicals en cadena, o páginas sin ninguno.
Códigos de respuesta y redirecciones
Cada URL devuelve un código que le dice a Google qué ha pasado. Los que importan: 200 cuando todo va bien, 301 para un traslado permanente, 302 para uno temporal, 404 cuando no existe y 5XX cuando el servidor falla.
Los problemas habituales son enlaces internos que apuntan a redirecciones en lugar de al destino final, cadenas de dos o tres saltos, y páginas eliminadas que siguen indexadas y recibiendo impresiones.
Velocidad y Core Web Vitals
Google publica los valores de LCP, INP y CLS que considera de referencia: 2,5 segundos o menos de LCP, 200 milisegundos o menos de INP y menos de 0,1 de CLS.
Dos detalles que cambian cómo se trabaja. El primero es que se miden en el percentil 75 de los usuarios reales sobre una ventana rodante de 28 días, así que después de corregir algo hay que esperar semanas para saber si funcionó. El segundo es que la métrica cambió: el INP sustituyó al antiguo FID el 12 de marzo de 2024, y muchas webs que estaban en verde pasaron a amarillo sin haber tocado nada.
Móvil y renderizado
Google indexa la versión móvil de las webs, así que lo que no esté en móvil no cuenta. El problema silencioso aquí es el contenido que depende de JavaScript: si la página llega vacía y se rellena después, Google tiene que renderizarla en una segunda pasada, y eso retrasa la indexación o la impide si algo falla por el camino.
HTTPS y seguridad
El certificado es requisito mínimo desde hace años. Los fallos que quedan son de segundo orden: certificados caducados, contenido mixto que carga recursos por HTTP dentro de una página segura, y la cabecera HSTS sin configurar.
Datos estructurados
Es el código en formato JSON-LD que describe qué es cada página para que el buscador lo entienda con precisión. Habilita resultados enriquecidos y, cada vez más, ayuda a que los modelos de IA identifiquen bien la entidad de un negocio.
El error más frecuente no es de sintaxis sino de semántica: marcar una página de servicio como artículo, declarar una empresa como persona, o dejar bloques de relleno que vinieron con la plantilla.
Webs multiidioma y hreflang
Solo aplica si hay varias versiones por idioma o país. El hreflang le dice a Google qué versión servir a cada usuario, y un error aquí hace que un visitante español reciba la versión mexicana. Es un fallo que se ve incluso en sitios grandes.
Cómo diagnosticar qué falla en tu web
Esta es la parte que casi ninguna guía cubre. Las listas de buenas prácticas dicen qué hay que hacer, pero no cómo saber cuál de esas cosas te está afectando a ti. El orden correcto es partir del síntoma, no de la lista.
| Síntoma | Causa probable | Dónde se comprueba |
|---|---|---|
| La página no aparece en Google ni buscando su título exacto | No está indexada: noindex, bloqueo en robots.txt o canonical a otra URL | Inspección de URL en Search Console |
| Tienes muchas más páginas publicadas que indexadas | Rastreo desperdiciado, contenido duplicado o páginas sin valor suficiente | Informe de indexación de páginas |
| Recibes impresiones para URLs que ya borraste | Páginas eliminadas sin redirigir que siguen en el índice | Rendimiento filtrado por página |
| Las posiciones caen sin cambios de contenido | Velocidad degradada, errores de servidor o una actualización del algoritmo | Estadísticas de rastreo y Core Web Vitals |
| Google indexa una versión distinta de la que esperas | Canonical mal configurado o varias versiones accesibles (con y sin www, http y https) | Inspección de URL, campo de canonical seleccionada |
| El rich result no sale aunque el schema esté puesto | Tipo de schema incorrecto o campos obligatorios ausentes | Prueba de resultados enriquecidos |
| Googlebot recibe algo distinto que tu navegador | Protección antibot, bloqueo por tasa o configuración del servidor | Prueba de URL publicada, mirando el HTML renderizado |
Search Console es la herramienta que resuelve casi todas estas comprobaciones y es gratuita. Antes de contratar nada, ese informe de indexación te dice más sobre el estado real de tu web que cualquier puntuación de una herramienta de pago.
Un aviso sobre el alcance: si el diagnóstico descarta todas estas causas y la página sí se indexa pero no sube, el problema no es técnico. Ahí toca revisar si la página responde a lo que busca el usuario, que es un trabajo distinto y con otras herramientas.
Ejemplos de problemas de SEO técnico reales
Una web que servía una pantalla de espera a los rastreadores. Todas sus URLs devolvían código 200, así que ninguna herramienta las marcaba como error. Lo que devolvían era la pantalla intermedia de un sistema antibot: título de veinte caracteres, sin H1, sin descripción, sin canonical y sin contenido. El sistema de seguridad estaba en modo agresivo y no distinguía entre un rastreador legítimo y uno malicioso. El síntoma visible era que apenas se indexaban páginas, y la causa parecía ser que el dominio era nuevo.
Páginas eliminadas que seguían captando impresiones. Un grupo de páginas de servicio por zona se borró en un rediseño sin redirigir. Meses después seguían indexadas, apareciendo en posiciones muy bajas para búsquedas locales con intención comercial y devolviendo un 404 a quien hacía clic. Cada impresión era un cliente potencial mandado a una página de error.
Dos páginas comerciales tardando diez segundos en cargar. Imágenes sin comprimir de varios megas y una plantilla que cargaba catorce hojas de estilo. Las dos páginas afectadas eran justo las que tenían que convertir.
Archivos de fecha generando URLs fantasma. El blog tenía activados los archivos por año y mes, que redirigían a la home. Varios enlaces internos apuntaban a ellos, así que el rastreo se iba en URLs que no existían como contenido.
Herramientas para el SEO técnico
- Search Console. Gratuita y obligatoria. Indexación, rendimiento, estadísticas de rastreo, Core Web Vitals con datos reales e inspección de URL individual.
- Un rastreador de escritorio. Recorre el sitio como lo haría Google y saca códigos de respuesta, canonicals, títulos duplicados y cadenas de redirección. Es lo que convierte una sospecha en una lista de URLs.
- PageSpeed Insights. Combina datos de laboratorio con datos de campo. Los que importan son los de campo, porque son los que Google usa.
- La prueba de resultados enriquecidos. Valida los datos estructurados y dice qué campos faltan.
Ninguna de estas herramientas decide nada por ti. Devuelven cientos de avisos y la mayoría no afecta al posicionamiento. Saber cuáles de esos avisos son el problema real es la parte que no automatiza ningún programa.
Qué ya no es SEO técnico
Hay recomendaciones que siguen apareciendo en guías publicadas este año y que están obsoletas:
- AMP. Dejó de ser requisito para aparecer en las noticias destacadas de Google, y hoy mantenerlo añade una versión más que rastrear sin beneficio de posicionamiento. Aun así aparece como buena práctica en artículos que ocupan el top 5 de esta búsqueda.
- El meta keywords. Google no lo usa desde 2009 y sigue apareciendo en plantillas.
- Perseguir el cien por cien en las herramientas. Una puntuación de 100 en un test de velocidad no es un objetivo de negocio. Los umbrales de Core Web Vitals sí lo son, porque son los que Google mide.
- Densidad de palabra clave. Nunca fue técnico y además hace años que no funciona. La guía de Google para empezar con el posicionamiento insiste en colocar los términos donde tienen sentido, no en repetirlos.
Cuánto cuesta y cuánto tarda el SEO técnico
No se contrata suelto en nuestros proyectos: forma parte del servicio de posicionamiento, cuyo punto de partida son 500 € al mes sin permanencia. La razón es que un arreglo técnico aislado rara vez mueve el negocio si después no hay contenido ni autoridad detrás.
En esfuerzo, es la partida que se concentra al principio. Los dos primeros meses se llevan la auditoría y las correcciones que desbloquean, y a partir de ahí baja a mantenimiento y vigilancia. Los plazos en los que se nota:
| Corrección | Cuándo se ve el efecto |
|---|---|
| Desbloquear una página que no se indexaba | Días o pocas semanas |
| Arreglar 404 y redirecciones | 2 a 6 semanas |
| Corregir datos estructurados | 2 a 8 semanas |
| Mejorar Core Web Vitals | Mínimo 28 días, por la ventana de medición |
| Reestructurar arquitectura y enlazado | 2 a 4 meses |
Una advertencia sobre las expectativas: el SEO técnico desbloquea, no empuja. Arreglar la indexación de una web que no tenía contenido relevante hará que sus páginas entren en el índice, y ahí se quedarán, en la posición que merezca su contenido. Quien vende una corrección técnica prometiendo un salto de posiciones está vendiendo el efecto equivocado.
Verko: primero se comprueba qué está roto, después se escribe
La auditoría técnica es el primer paso de nuestro método y condiciona todo lo que viene detrás. Revisamos indexación, códigos de respuesta, velocidad, arquitectura y datos estructurados, y salimos con una lista de URLs concretas y una prioridad, no con un informe de cientos de avisos genéricos.
Puedes ver qué incluye nuestra auditoría técnica, con el alcance de la revisión y lo que se entrega. La primera auditoría es gratuita e incluye el estado de indexación real de tu web.